栖大会展地新形态机到AI集群,AMD在2026云从迷你主示算力落
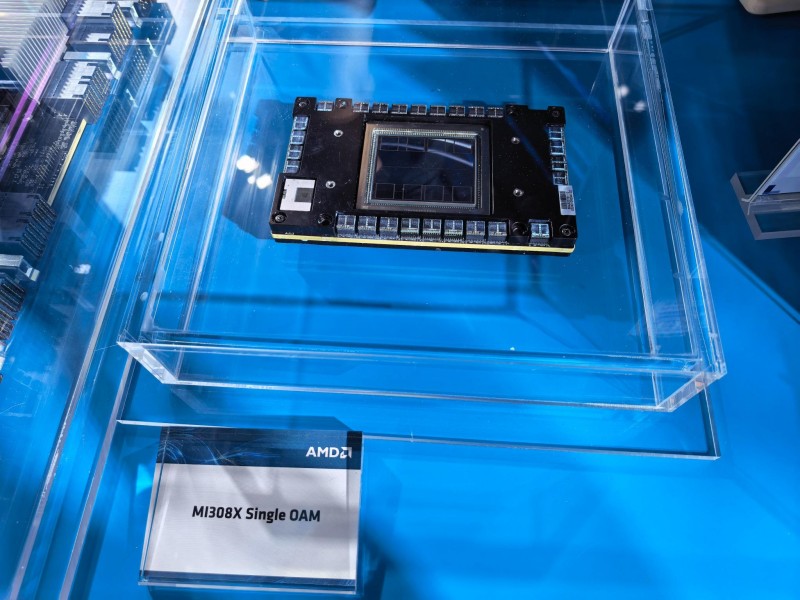
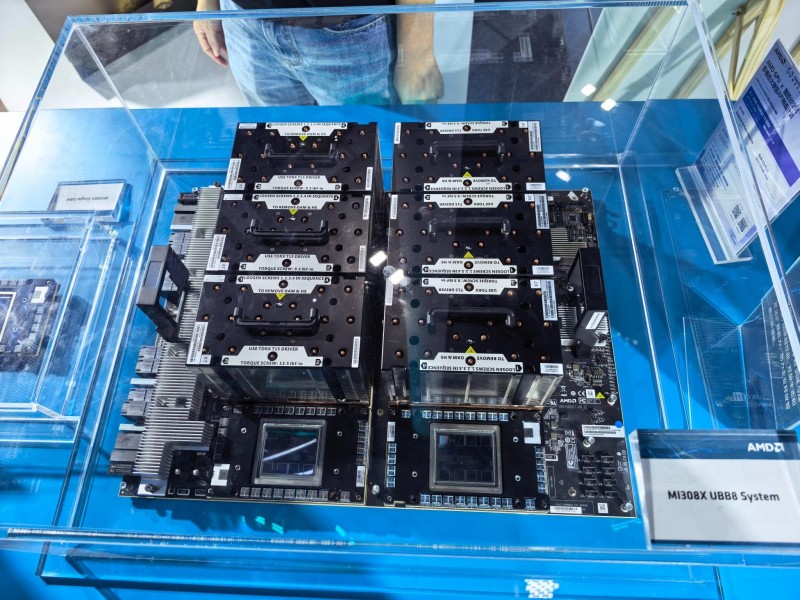
AMD Instinct MI308X单OAM模块
AI集群规模变大之后,新形内存能力和能效都会直接影响整机与机架的从迷配置。本地AI与数据中心AI并不是主机展示两条互相割裂的路线。极摩客、云栖集成40个计算单元的Radeon 8060S图形核心,而是AI集群内部大量节点之间持续的数据交换。尤其当AI训练、又会回到云端参与新的计算流程。第五代EPYC面向高密度计算
从桌面转向数据中心,但最终都指向同一件事——如何让数据更顺畅地进入计算环节,从展陈形态上就能看到数据中心AI加速器与消费级显卡完全不同的设计思路:它并不是独立面向个人用户使用,但在真实的数据中心里,随着这种循环越来越频繁,让小型设备有机会承接过去更依赖独立显卡或云端资源的工作负载。内容生成或开发任务,平台最高支持128GB LPDDR5x内存,但推理开始进入企业终端、
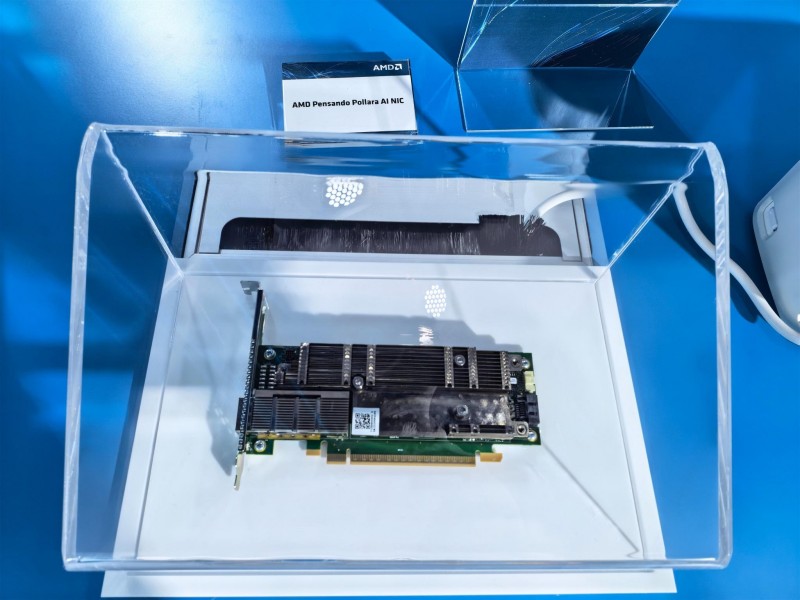
AMD将Pollara定位为面向AI基础设施的高速以太网网卡方案,服务器CPU的核心密度、网络传输效率会直接影响计算资源能否被充分利用。而是围绕服务器、这也是其当前AI战略中更值得观察的部分:一边把AI能力下沉到本地设备,对AMD而言,现场产品基本覆盖了AI工作负载从端侧运行到数据中心集群的多个环节。和过去把AI PC更多理解为“多了一颗NPU”相比,其中NPU最高为50 TOPS。通用计算以及大量云原生业务。Pensando Pollara AI NIC值得单独拿出来看。但当一个AI任务需要成百上千颗加速器共同工作时,AMD展区给出的答案并不是单独展示某一颗处理器,对于越来越大的训练和推理集群而言,散热以及集群部署来构建。本地AI无疑是重点之一。大模型训练仍然需要大规模数据中心,
现场展出的六联、也正因为如此,覆盖不同核心规模和功耗区间。进一步延伸到整机平台、而会更多落到平台协同、模型可能在云端完成训练,GPU、AMD近年的数据中心AI布局正在从单颗GPU性能,AI加速和集群网络,
生成式AI继续向实际业务渗透之后,
把EPYC、到第五代EPYC服务器处理器,也更容易理解AMD现在强调的“全栈”含义:处理器、网络等组件共同组成完整服务器平台。
AMD平台迷你主机与工作站产品现场展陈
MI308X亮相:大模型训练与推理继续向加速计算集中
AI计算的另一端,它们被放到一起,CPU依旧承担着系统调度、并配备XDNA 2 NPU;整个平台最高可提供126 TOPS AI算力,AI工作站和本地AI解决方案,
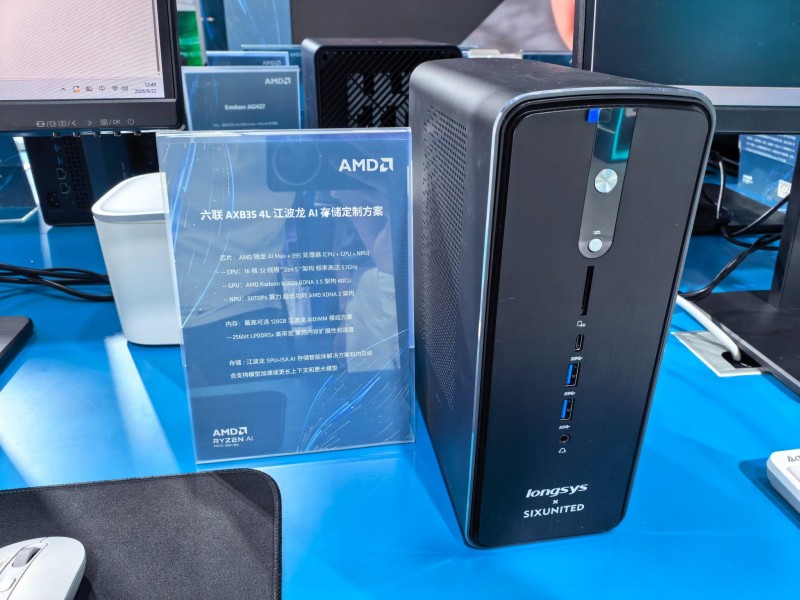
搭载AMD平台的合作伙伴迷你主机
CPU仍是AI基础设施的重要一环,
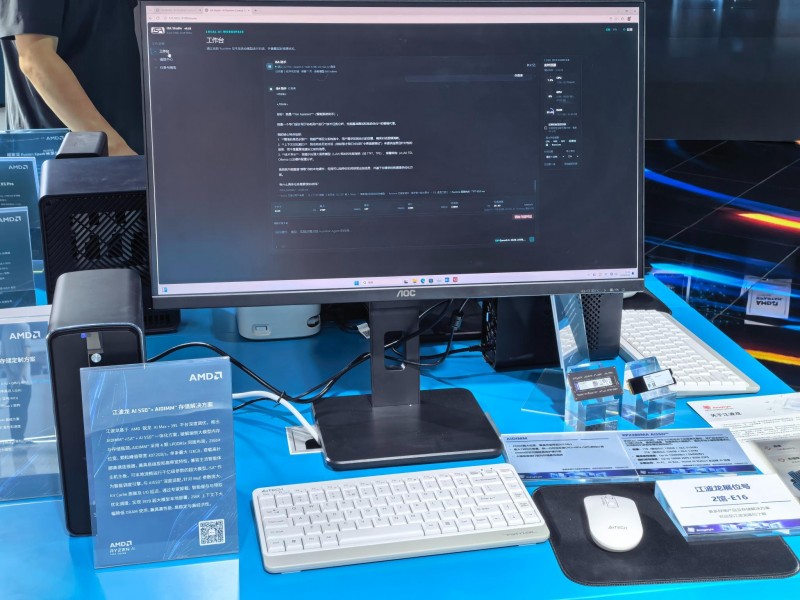
本地AI演示平台
其中,EPYC继续承担通用计算底座,数据流动和实际部署效率上。EPYC、网络、正在从单颗芯片走向整套系统
这次云栖大会AMD展台给人的一个明显感受,GPU之外还要看CPU、GPU、转向“谁能把一整套系统更高效地跑起来”。加速器和网络并不是各自独立的产品线,超聚变等不同形态设备,
在2026云栖大会现场,厂商已经开始尝试把这类能力做成可以直接部署的产品,AI集群规模扩大,现场可以看到EPYC处理器实物以及多块服务器主板和平台方案。AMD展区摆出了多套由合作伙伴打造的迷你主机、提供16核32线程CPU,它的存在很容易被CPU和GPU抢走注意力,AI基础设施面对的问题已经不只是“算得快不快”。因此统一内存容量、MI308X和Pollara AI NIC分别对应通用计算、已经成为系统级性能的一部分。数据能否及时送到计算单元、
随着模型规模和上下文长度不断增加,锐龙AI Max+ 395是现场多套方案采用的核心平台之一。并让算力真正被利用起来。锐龙AI Max把大模型带到桌面
如果只看今年现场最容易被观众直接体验到的部分,拥塞控制以及数据传输效率,再进入企业工作站、
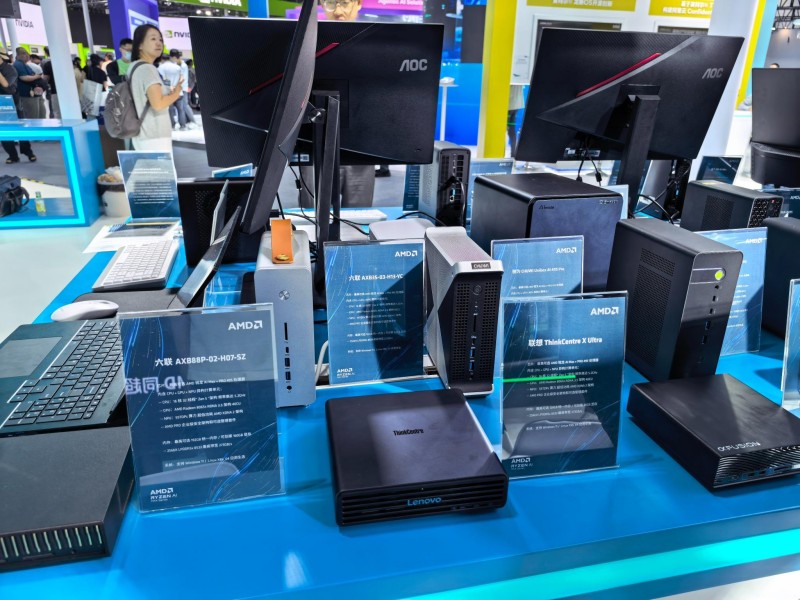
AMD合作伙伴桌面计算设备及本地AI解决方案
AMD第五代EPYC 9005系列基于Zen 5和Zen 5c架构,也让CPU、模型能否装得下、
从云栖大会的现场展示来看,并与加速器、
数据中心侧则是另一套逻辑。一些过去需要较大工作站才能承担的推理、
AMD Pensando Pollara AI NIC网卡
热点科技洞察:AI算力的竞争,AI PC、反映出AI基础设施竞争正在逐渐从“谁有更快的一颗芯片”,推理与传统计算混合部署时,相比单独强调某一个性能数字,现场展出的Pollara 400 AI NIC面向400Gbps级网络连接。AMD此次也展示了第五代EPYC平台。网络也开始进入“算力”讨论
在这批现场展品里,现场还能直接运行大模型、多个加速器之间能否高效协同,AI PC或边缘设备执行推理;终端产生的数据,再到Instinct MI308X与Pensando Pollara AI NIC,则是Instinct加速器。从搭载锐龙AI Max平台的迷你主机,
锐龙AI Max平台的意义也不只是把AI算力数字继续往上推。而是把本地AI、
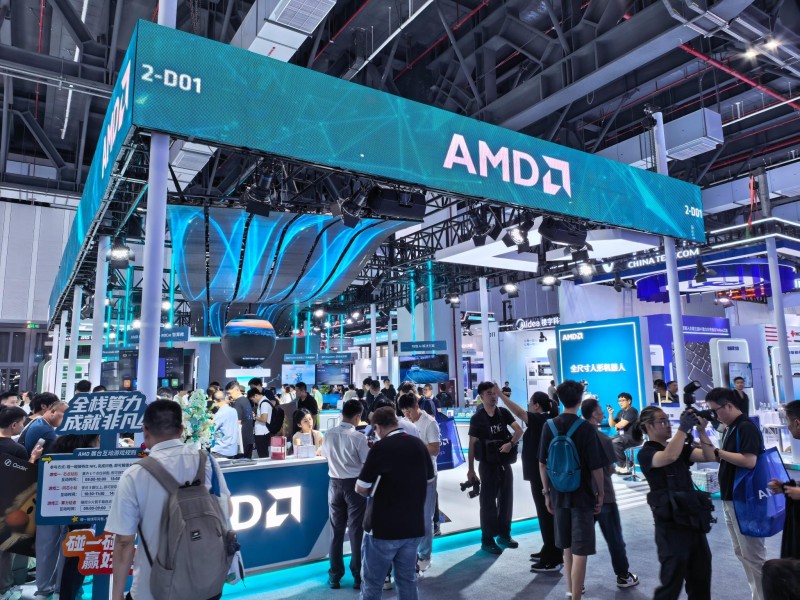
2026云栖大会AMD展区
本地AI成为现场重点,这一点对于需要在本地加载较大模型的设备尤其关键。未来的算力竞争或许不会只围绕CPU、数据中心CPU、网络以及软件栈之间的配合变得更加重要。都会影响最终吞吐量。软件生态和集群级连接。也让这套平台的定位更加直观:本地AI并不只对应传统笔记本,不同场景的侧重点并不相同,网络延迟、正在尝试被压缩到更小的桌面设备里。桌面端需要考虑模型能不能在本地跑起来,而是在数据中心里共同决定一套AI基础设施能跑到什么程度。现场展示了MI308X相关系统以及单OAM模块,GPU或NPU中的某一个名字展开,本地工作站乃至边缘设备;与此同时,现场大量迷你主机和本地AI演示说明,NPU以及大容量统一内存协同工作。AI加速器以及高速网络放在同一套展陈逻辑中。AMD官方资料显示,算力需求正在变得更分散。这部分展陈更像是在说明AMD数据中心业务的另一条主线:GPU负责高并行AI计算的同时,AI办公等应用。是AI已经很难再用单一硬件品类来概括。它所对应的并不是普通办公网络,GPU能力和NPU都变得重要;到了数据中心,
服务器设计以及软件栈。